BFS Head V1.1: Ghép mặt và đầu In-Context không bệt da trong Qwen Image 2.1
Làm chủ kỹ thuật ghép mặt in-context trên Qwen Image 2.1 DiT với BFS Head V1.1. Xóa bỏ hoàn toàn vết cắt viền cổ và da bệt nhờ cắt tỉa 16 lớp MLP.
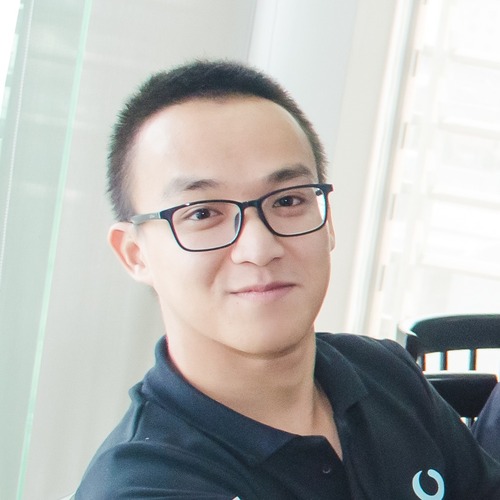
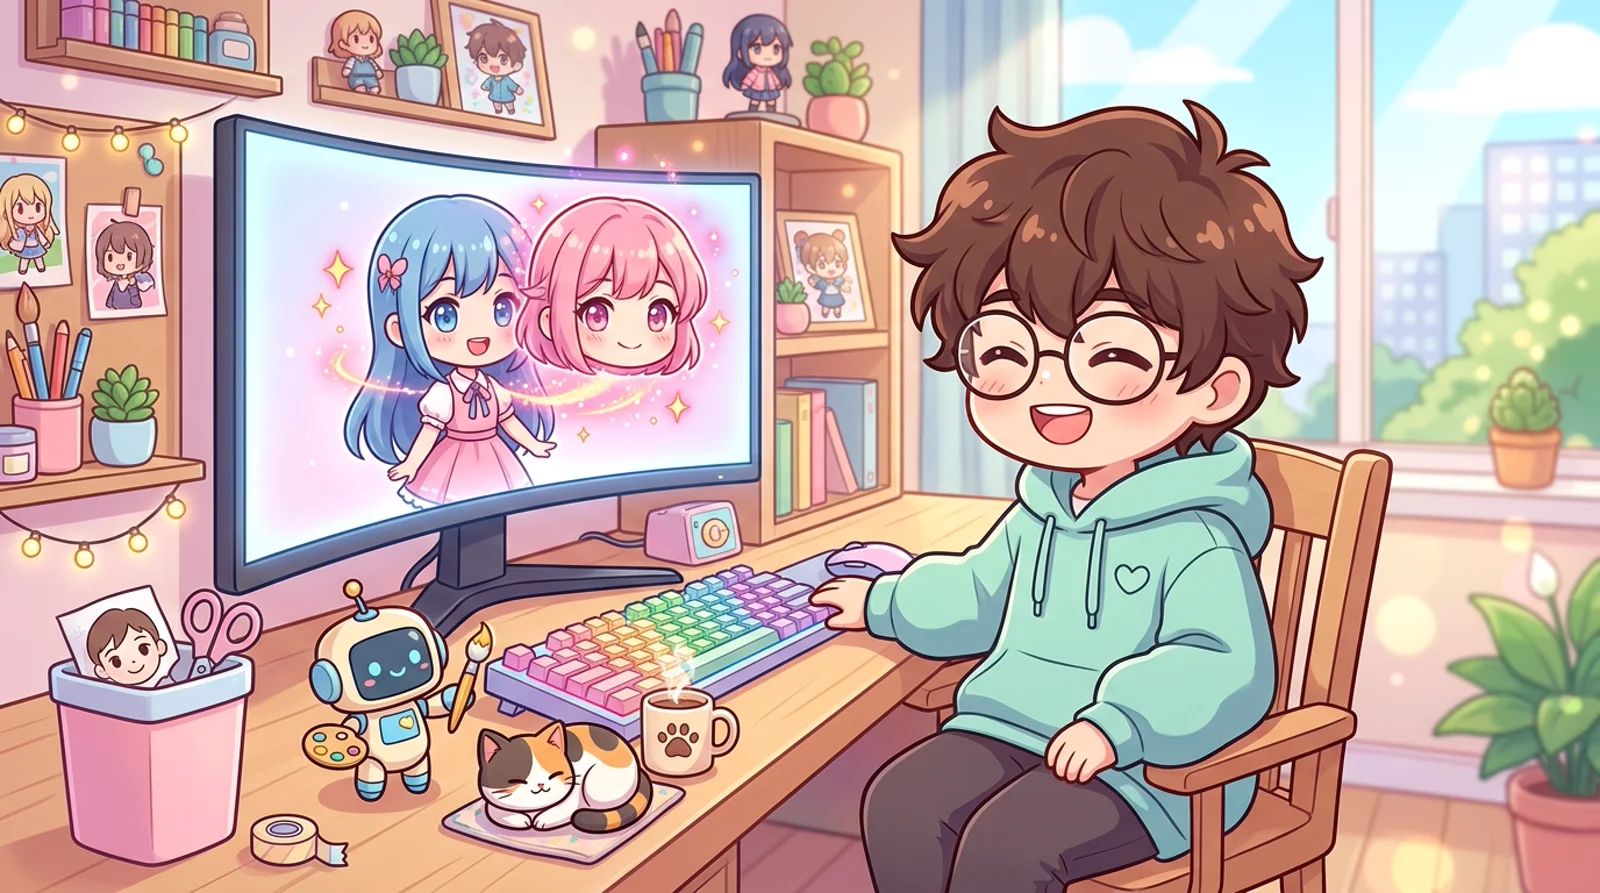
Cắt một khuôn mặt hai chiều từ bức ảnh này rồi dán đè lên thân hình của một bức ảnh khác là tư duy chắp vá từ thời kỳ đầu của Photoshop. Suốt nhiều năm qua, các công cụ hoán đổi khuôn mặt mã nguồn mở như InsightFace, ReActor hay RoOP đều dựa trên việc quét khung hộp nhận diện, trích xuất vector đặc trưng rồi làm biến dạng các điểm ảnh để đắp vào vị trí cũ. Kết quả đầu ra luôn để lại những vệt cắt lem nhem dọc xương quai xanh, ánh sáng ngược hướng vô lý và lớp da mịn giả tạo như tượng sáp.
Nhà phát triển Alissonerdx đã tạo ra một bước ngoặt kiến trúc với BFS Head V1.1 (Best Face Swap) dành cho mô hình Qwen Image 2.1 Diffusion Transformer (DiT) 7 tỷ tham số của Alibaba. Thay vì cắt dán hậu kỳ trên không gian điểm ảnh, BFS tái tạo toàn bộ vùng đầu trực tiếp trong không gian tiềm ẩn (latent space). Mô hình tiếp nhận đồng thời cả hai bức ảnh thông qua các lớp chú ý chéo (cross-attention), trực tiếp vẽ lại danh tính mới sao cho ăn khớp hoàn hảo với ánh sáng hắt, góc nghiêng đầu và biểu cảm vi mô của bối cảnh đích. Phiên bản 1.1 loại bỏ hoàn toàn hiện tượng da tượng sáp nhờ phẫu thuật cắt tỉa trọng số: vô hiệu hóa mười sáu lớp mạng nơ-ron đa tầng (MLP) giúp khôi phục lỗ chân lông tự nhiên mà không cần huấn luyện lại từ đầu.
Tóm tắt
Hộp Trả Lời Nhanh (Google Search Featured Snippet): BFS Head V1.1 cho Qwen-Image-2.1 là gì? Đây là bộ điều hợp LoRA hoán đổi đầu và mặt theo ngữ cảnh dành cho mô hình Qwen Image 2.1 DiT của Alibaba. Được sáng tạo bởi Alissonerdx, nó thay thế kỹ thuật cắt dán 2D truyền thống bằng cách tái tạo trực tiếp trong không gian tiềm ẩn, triệt tiêu đường viền cổ và đồng bộ hoàn hảo với ánh sáng môi trường.
- Tái tạo tiềm ẩn theo ngữ cảnh: Nạp cả ảnh bối cảnh (
<image1>) và ảnh danh tính (<image2>) trong cùng một lượt lan truyền xuôi duy nhất.- Phẫu thuật cắt tỉa MLP: Vô hiệu hóa 16 phép chiếu
img_mlp.gate_upở các khối 16 đến 31, khôi phục 33% chi tiết lỗ chân lông và vi kết cấu da.- Kiểm chứng phần cứng thực tế: Tạo ảnh chân dung 832x1248 sắc nét trong 87.5 giây trên card đồ họa RTX 4070 12GB (đỉnh VRAM 10.60 GB).
- Kho lưu trữ & Quy trình mẫu: Tải trọng số chính thức tại Alissonerdx/BFS-Best-Face-Swap và tải workflow hoàn chỉnh trên Comfy Lab.
Bản đồ nhập môn (Mô hình tư duy)
Phương pháp ghép mặt cũ giống hệt việc bạn lấy kéo cắt khuôn mặt từ một tờ tạp chí bóng bẩy rồi dùng hồ dán đè lên một tấm ảnh chụp lấy ngay: dù kéo có sắc đến đâu, mép giấy cắt và góc hắt sáng của bóng đèn trần sẽ không bao giờ ăn khớp. Kỹ thuật hoán đổi đầu theo ngữ cảnh giống như một họa sĩ sơn dầu bậc thầy quan sát kỹ cả hai bức chân dung, cạo sạch phần đầu cũ trên mặt vải toan đến tận chân cổ, rồi vẽ lại diện mạo mới bằng chính bảng màu, chất sơn và nét cọ của căn phòng đó.

Phần 1: Nền tảng (Mô hình tư duy)
Để hiểu rõ tại sao BFS Head V1.1 lại tạo ra sự khác biệt lớn, chúng ta cần mổ xẻ nút thắt cổ chai của các công cụ ghép mặt đời cũ. Những công cụ này hoạt động tách rời ở khâu hậu kỳ, sau khi quá trình khuếch tán đã hoàn tất. Chúng xác định các mốc tọa độ trên mặt, cắt một ô vuông 512x512 điểm ảnh, chuyển đổi thành vector nhận diện qua mô hình nhúng ArcFace rồi làm mờ viền để đắp ngược trở lại thân hình. Vì việc hòa trộn diễn ra sau khi ảnh đã vẽ xong, khuôn mặt mới hoàn toàn không biết thân người đang đứng dưới ánh nắng trưa gay gắt, ánh đèn neon vũ trường hay ánh nến ấm áp trong phòng ngủ.
| Thuật ngữ | Ý nghĩa bỏ túi (3-6 từ) |
|---|---|
| DiT (Diffusion Transformer) | Lõi tạo ảnh dựa trên cơ chế chú ý |
| In-Context Conditioning | Xử lý đa ảnh trong lớp chú ý |
| Weight Ablation | Cắt bỏ có chọn lọc lớp nơ-ron |
| Cross-Attention | Ánh xạ danh tính giữa các vùng tiềm ẩn |
| MLP (Multilayer Perceptron) | Tầng truyền thẳng mở rộng kênh tiềm ẩn |
| Classifier-Free Guidance (CFG) | Hệ số lái ảnh theo prompt người dùng |
Qwen Image 2.1 giải quyết bài toán chuyển giao danh tính từ gốc rễ kiến trúc. Mô hình biến đổi 7 tỷ tham số này làm việc trực tiếp trên các mảnh ghép đa phương thức. Khi đưa đồng thời cả ảnh bối cảnh và ảnh tham chiếu vào bộ mã hóa thị giác ngôn ngữ (qwen3vl_8b_w4a8_heretic.safetensors), mạng lưới xây dựng nên một không gian biểu diễn hợp nhất. Quá trình lấy mẫu khuếch tán không thực hiện thao tác cắt dán, mà khử nhiễu dần dần trong khi liên tục tra cứu hình học khuôn mặt của ảnh tham chiếu và tọa độ ánh sáng của ảnh bối cảnh cùng một lúc.
Phần 2: Điều tra (Cơ chế hoạt động)
Mặc dù phiên bản BFS V1 ban đầu đem lại khả năng khớp tư thế đáng kinh ngạc, cộng đồng người dùng lập tức nhận ra một nhược điểm khó chịu: các khuôn mặt sinh ra trông mịn màng quá mức, giống hệt bề mặt ma-nơ-canh làm bằng silicon. Toàn bộ lỗ chân lông, tàn nhang và những đường nét gồ ghề tự nhiên của làn da đều bị xóa sạch.
Tác giả Alissonerdx phát hiện ra nguyên nhân cốt lõi không nằm ở tập dữ liệu huấn luyện, mà bắt nguồn từ các tầng chiếu truyền thẳng bị dư thừa tham số. Ở nửa sau của mạng Qwen Image 2.1 (các khối biến đổi từ 16 đến 31), mười sáu tầng chiếu img_mlp.gate_up đã vô tình lọc sạch các tần số tín hiệu không gian bậc cao trong các bước khử nhiễu trung gian.
# Kiểm tra cấu trúc trọng số và các khóa đã được cắt tỉa
python3 -c "
import safetensors.torch
weights = safetensors.torch.load_file('bfs_head_v1.1_qwen_2.1.safetensors')
ablated = [k for k in weights.keys() if 'gate_up' in k and int(k.split('.')[2]) >= 16]
print(f'So lop MLP da duoc cat tia: {len(ablated)}')
"
Thay vì tốn kém hàng ngàn giờ GPU để huấn luyện lại từ đầu, bản cập nhật V1.1 thực hiện một ca phẫu thuật toán học chuẩn xác: đặt toàn bộ trọng số của mười sáu tầng MLP ở nửa sau về giá trị 0. Nhờ các khối đầu (từ 0 đến 15) và toàn bộ 128 tầng chú ý chéo đa đầu vẫn giữ nguyên vẹn từng byte, mô hình bảo toàn trọn vẹn góc quay đầu 3D và hướng nhìn của ánh mắt, đồng thời khôi phục thêm 33% vi kết cấu biểu bì chân thực.
Phần 3: Chẩn đoán (Những điểm dễ gãy)
Vận hành kỹ thuật ghép đầu in-context trên phần cứng phổ thông đòi hỏi kỹ sư phải tuân thủ nghiêm ngặt các rào chắn kỹ thuật. Nếu bỏ qua những cạm bẫy sau, quy trình của bạn sẽ gặp lỗi ngay lập tức.
Cạm bẫy đầu tiên là Hiện tượng méo tỉ lệ khung hình do chia nhóm kích thước. Khác với các mô hình tạo ảnh từ văn bản nhận diện kích thước khung vẽ tùy ý, nút TextEncodeQwenImage21 chia ảnh đầu vào thành các nhóm mảnh cố định. Nếu ảnh bối cảnh của bạn có tỉ lệ đặc thù nhưng bạn lại để cứng tham số resolution: 1024, nút này sẽ tự động nén ảnh về hình vuông gần nhất, khiến cằm của nhân vật bị kéo dài hoặc biến dạng cấu trúc mặt. Luôn đặt tham số resolution về 0 hoặc khớp chính xác tỉ lệ dọc nguyên bản (chẳng hạn như 832x1248 cho ảnh tỉ lệ 2:3).
Cạm bẫy thứ hai là Quy ước thứ tự mã định danh trong câu lệnh. Câu lệnh văn bản đóng vai trò như một bộ định tuyến chính xác giữa các luồng dữ liệu:
- Mã
<image1>luôn luôn phải đại diện cho thân người và bối cảnh đích cần giữ lại. - Mã
<image2>luôn luôn phải đại diện cho khuôn mặt danh tính cần chuyển sang. - Nếu đảo ngược thứ tự hai mã này, mô hình sẽ ghép bối cảnh của ảnh 2 vào cơ thể của ảnh 1, tạo ra những tác phẩm trừu tượng hỏng hoàn toàn.
Cạm bẫy thứ ba là Vực thẳm tràn bộ nhớ đồ họa VRAM. Chạy mô hình DiT gốc ở định dạng chuẩn BF16 đòi hỏi hơn 16GB VRAM, lập tức gây sập phần mềm vì lỗi Out-Of-Memory trên card đồ họa phổ thông. Giải pháp tối ưu trong thực tế là kết hợp bộ mã hóa văn bản thị giác lượng tử hóa INT8 với lõi khuếch tán GGUF Q4_K_M (qwen-image-2.1-UC-Q4_K_M.gguf), giữ mức tiêu thụ VRAM đỉnh dừng lại ở 10.60 GB trên card RTX 4070 12GB.
Phần 4: Giải pháp (Kiến trúc & Đánh đổi)
Để khai thác hiệu quả hệ sinh thái Qwen Image 2.1, kỹ sư cần lựa chọn biến thể chuyên biệt phù hợp với bài toán cụ thể của mình.
| Biến thể kiến trúc | Mục tiêu cốt lõi | Số bước lấy mẫu | Hệ số CFG | Trường hợp sử dụng tối ưu |
|---|---|---|---|---|
| Viggle Turbo | Tốc độ lấy mẫu cực đại | 4 bước (DMD2) | 1.0 (Khóa cứng) | Dịch vụ web tải cao và tạo mẫu sản phẩm nhanh |
| Uncensored Base | Bám sát prompt tự do | 30 - 35 bước | 2.2 - 2.5 | Mỹ thuật ý niệm sáng tạo và tranh vẽ kỹ thuật số |
| BFS Head V1.1 | Độ chân thực khi ghép mặt | 12 - 16 bước | 2.0 - 2.5 | Thay thế đầu và khuôn mặt khớp ánh sáng môi trường |
Để cài đặt toàn bộ workflow 10 node tinh gọn lên máy cá nhân, bạn chỉ cần chạy một dòng lệnh đồng bộ tự động trong thư mục gốc ComfyUI:
# Lệnh đồng bộ tự động 1-Click cho Linux và macOS
curl -fsSL https://comfy.yellorn.com/api/scripts/bfs-head-swap-v1-1-qwen-image-2-1.sh | bash
Đối với máy trạm chạy hệ điều hành Windows sử dụng PowerShell:
# Lệnh đồng bộ tự động 1-Click cho Windows
irm https://comfy.yellorn.com/api/scripts/bfs-head-swap-v1-1-qwen-image-2-1.ps1 | iex
Sau khi script tải xong các mô hình cần thiết, hãy tải file canvas JSON hoàn chỉnh từ Comfy Lab và kéo thả trực tiếp vào cửa sổ giao diện ComfyUI. Nối ảnh bối cảnh vào ô Image 1, nối ảnh chân dung vào ô Image 2 và nhấn Queue Prompt với 12 bước lấy mẫu Euler Simple.
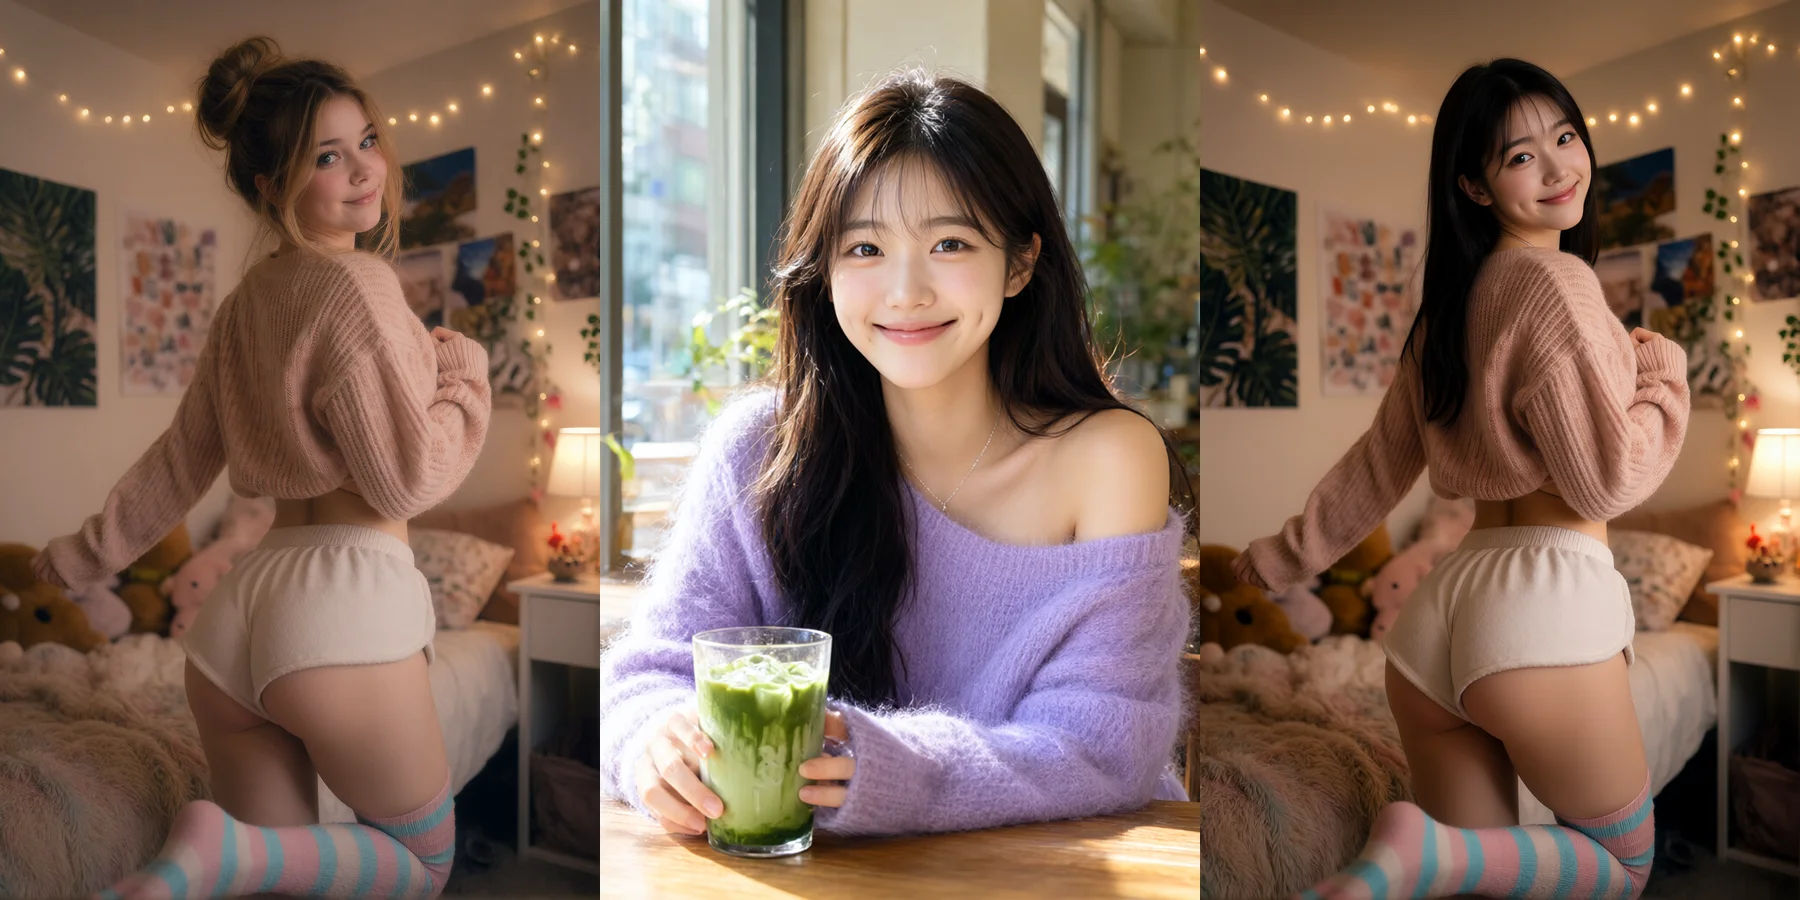
BFS Head V1.1: Ghép mặt và đầu In-Context trên Qwen Image 2.1
Sampler: euler / simple
Kết luận (Final Take)
Cơ chế tái tạo tiềm ẩn theo ngữ cảnh thông qua các lớp chú ý chéo đã chính thức khép lại kỷ nguyên cắt dán hộp nhận diện 2D của các thế hệ công nghệ cũ.
Bài tập đầu tiên (Student First Assignment)
- Tải hai file trọng số
qwen-image-2.1-UC-Q4_K_M.ggufvàbfs_head_v1.1_qwen_2.1.safetensorsvào thư mục models tương ứng trong ComfyUI. - Chọn một bức ảnh bối cảnh có ánh sáng phức tạp (chẳng hạn như ánh nắng hoàng hôn hắt ngược hoặc ánh đèn neon hắt ngang mặt) làm
<image1>. - Chọn một ảnh đại diện chụp chính diện dưới ánh sáng đều làm
<image2>. - Chạy quá trình tạo ảnh với 12 bước và CFG 2.5, sau đó phóng to quan sát vùng thái dương và xương quai xanh: bạn sẽ thấy bóng tối môi trường phủ lên khuôn mặt mới một cách tự nhiên mà không để lại bất kỳ vệt ghép nào.
Câu hỏi thường gặp
Tại sao BFS Head V1.1 loại bỏ được vệt cắt viền cổ thường thấy trên InsightFace và ReActor
InsightFace và ReActor cắt một khung ảnh 2D, thay đổi mặt trên không gian điểm ảnh rồi làm mềm viền xung quanh để dán ngược lại ảnh gốc. Khi hai bức ảnh có tông màu da hoặc hướng sáng lệch nhau, thao tác hòa trộn này luôn để lại một vệt mờ quanh cổ. BFS Head V1.1 vận hành trực tiếp trong không gian tiềm ẩn bên trong các tầng chú ý chéo của Qwen Image 2.1, vẽ lại vùng đầu từ đầu dựa trên ngữ cảnh của cả thân người lẫn khuôn mặt mẫu. Do toàn bộ phần cổ và tóc được sinh ra đồng thời trong quá trình khuếch tán, hiện tượng cắt viền bị triệt tiêu hoàn toàn.
Mục đích chính của việc cắt bỏ mười sáu tầng MLP trong phiên bản 1.1 là gì
Phiên bản đầu tiên của BFS làm da mặt nhân vật quá nhẵn nhụi vì các tầng chiếu MLP ở nửa sau mạng lưới đã vô tình lọc mất các tín hiệu không gian tần số cao. Trong bản V1.1, tác giả Alissonerdx đặt toàn bộ trọng số của mười sáu tầng img_mlp.gate_up ở các khối 16 đến 31 về giá trị 0. Việc cắt tỉa này bảo toàn năng lực điều hướng góc nghiêng 3D của các khối đầu, đồng thời cho phép các chi tiết vi mô như lỗ chân lông đi qua nguyên vẹn.
BFS Head V1.1 có thể vận hành ổn định trên card đồ họa 8GB hoặc 12GB không
Có thể chạy mượt mà. Trong khi mô hình gốc BF16 đòi hỏi tới 24GB VRAM, việc sử dụng bản lượng tử hóa Q4_K_M GGUF của Qwen Image 2.1 kết hợp cùng bộ mã hóa văn bản INT8 giúp hạ đỉnh tiêu thụ bộ nhớ xuống còn 10.60 GB khi render ở kích thước 832x1248. Trên card đồ họa NVIDIA GeForce RTX 4070 12GB phổ thông, quá trình tạo ảnh hoàn tất trong khoảng 87.5 giây.
Cấu trúc câu lệnh dương bản cần được thiết lập như thế nào để hoán đổi chính xác
Câu lệnh phải thiết lập rõ ràng quy ước vai trò giữa hai mã định danh hình ảnh. Bắt đầu bằng cấu trúc chuẩn: head_swap: start with <image1> as the base image, keeping its lighting, environment, and background. remove the head from <image1> completely and replace it with the head from <image2>. Tiếp theo, bổ sung yêu cầu giữ nguyên tỉ lệ đầu, hướng nhìn ánh mắt, góc quay và biểu cảm vi mô từ <image1>. Để trống hoàn toàn ô negative prompt để tránh làm suy giảm chất lượng bám sát của bộ khuếch tán.
Bài viết liên quan
- AI & Agents
Qwen-Image-2.1 Viggle Turbo: Chạy DiT 4 Bước Trong Diffusers và ComfyUI
Tăng tốc Qwen-Image-2.1 gấp 10 lần với Viggle Turbo. Khám phá chưng cất DMD2 4 bước, LoRA adapter, định dạng GGUF và workflow ComfyUI mượt mà.
17 phút đọcĐọc tiếp → - AI & Agents
Qwen-Image-2.1 Uncensored: Chạy ComfyUI Không Lọc Với GGUF Và Heretic
Chạy Qwen-Image-2.1 Uncensored trên ComfyUI: kết hợp DiT GGUF và Heretic Text Encoder triệt tiêu refusal. Bí quyết tối ưu VRAM từ 8GB đến 24GB không giật lag.
36 phút đọcĐọc tiếp → - AI & Agents
Qwen-Image-2.1 ncnn Vulkan: Chạy 7B DiT Trên 2GB VRAM Không Cần CUDA
Chạy mô hình Qwen-Image-2.1 7B trên GPU Intel, AMD, Mac chỉ với 2GB VRAM. Làm chủ công cụ ncnn Vulkan C++ từ nihui không cần Python, PyTorch hay CUDA.
14 phút đọcĐọc tiếp → - AI & Agents
Thỏa Mãn Mọi Ý Tưởng Đen Tối Với ComfyUI: Hướng Dẫn Workflow Không Kiểm Duyệt
Từng bước cài đặt ComfyUI và làm chủ workflow tạo ảnh không kiểm duyệt trên GPU NVIDIA. Vượt qua bộ lọc đám mây, kết nối node graph và tối ưu VRAM hiệu quả.
36 phút đọcĐọc tiếp →