BitNet: Kỷ nguyên LLM 1-bit Cuối cùng đã Bắt đầu
Khám phá bitnet.cpp, framework chính thức của Microsoft dành cho các LLM 1-bit, giúp thay thế phép nhân bằng phép cộng để tăng tốc độ xử lý vượt trội.
BitNet: Kỷ nguyên LLM 1-bit Cuối cùng đã Bắt đầu
Trong nhiều năm, chúng ta đã cố gắng nén các Mô hình Ngôn ngữ Lớn (LLM) vào các thiết bị nhỏ hơn bằng cách sử dụng các kỹ thuật lượng tử hóa (quantization) như INT8 hay INT4. Nhưng Microsoft vừa thay đổi hoàn toàn cuộc chơi. Chào mừng bạn đến với kỷ nguyên của LLM 1-bit.
Phần 1: Nền tảng (Mô hình tâm trí - Mental Model)
Để hiểu về BitNet, cụ thể là biến thể BitNet b1.58, bạn cần thay đổi cách suy nghĩ về việc AI “tư duy” như thế nào.
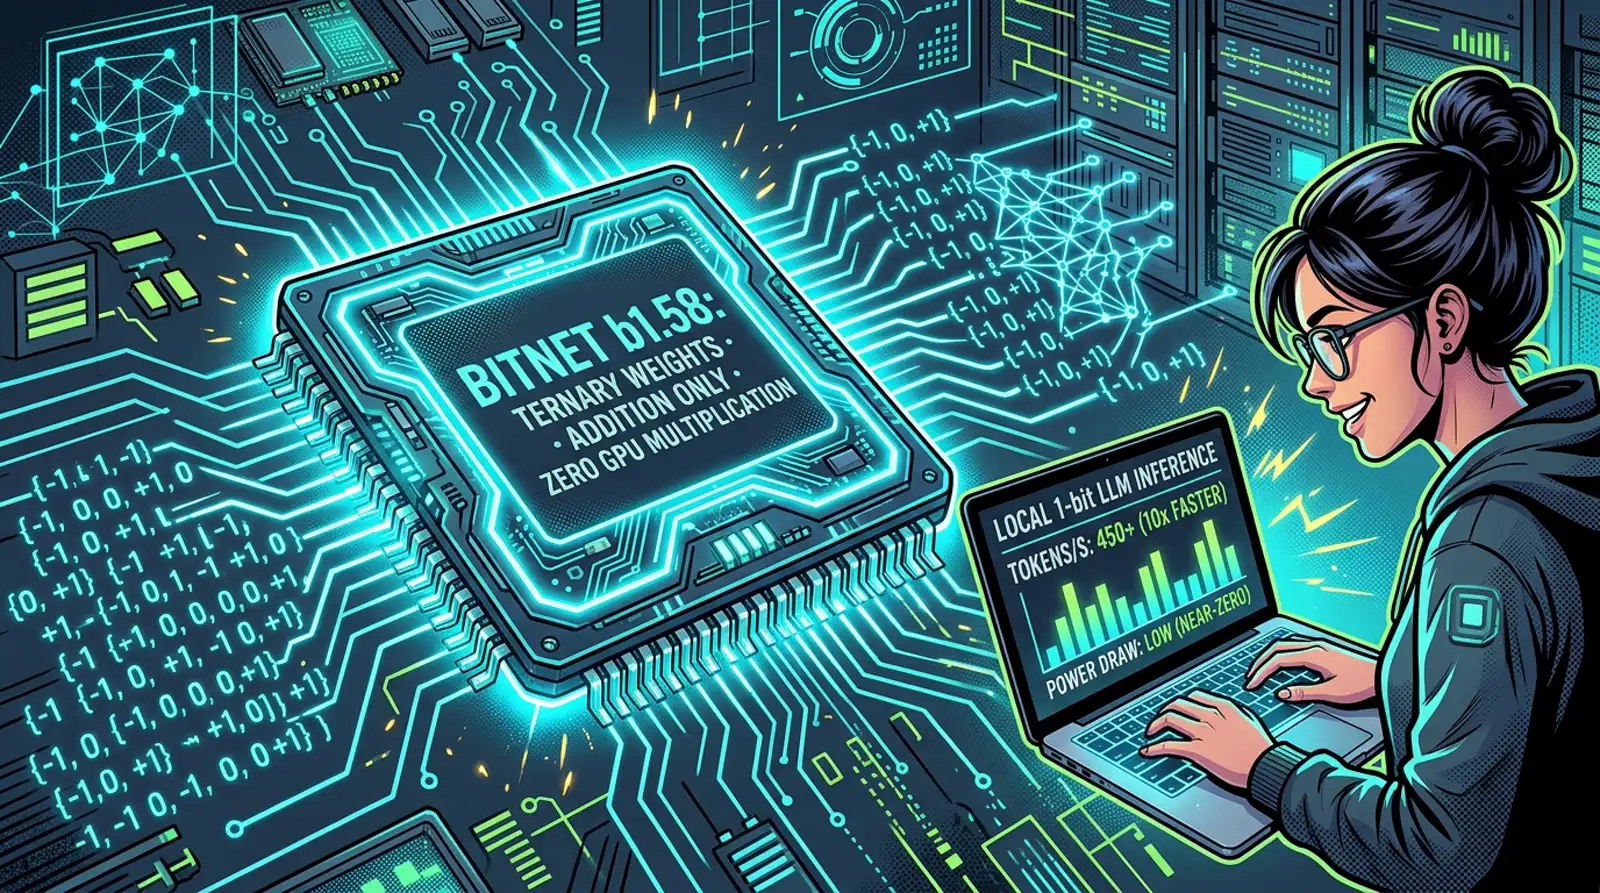
Các LLM truyền thống dựa vào một lượng khổng lồ các phép nhân dấu phẩy động (Matrix Multiplications). BitNet biến LLM từ một “Cỗ máy Nhân” thành một “Cỗ máy Cộng”.
Trong thế giới 1.58-bit, các trọng số (weights) là tam phân (ternary): chúng chỉ có thể nhận các giá trị -1, 0, hoặc 1. Điều này có nghĩa là mô hình không cần nhân các con số; nó chỉ cần cộng hoặc trừ chúng dựa trên các giá trị tam phân này.
Mô hình tâm trí ở đây là: Hiệu quả không chỉ đến từ những con số nhỏ hơn; nó đến từ những phép tính đơn giản hơn.
Phần 2: Cuộc điều tra (The Investigation)
Dự án bitnet.cpp là framework thực thi (inference) chính thức cho các mô hình 1-bit này. Nó được xây dựng dựa trên nền tảng vững chắc của llama.cpp nhưng giới thiệu các kernel chuyên biệt (như I2_S) được thiết kế riêng cho toán học tam phân.
Các điểm nhấn về kiến trúc:
- Kernel Tùy chỉnh: Được tối ưu hóa cho cả kiến trúc x86 (AVX2) và ARM (NEON/DOTPROD).
- Chiến lược Bảng tra cứu (Lookup Table): Sử dụng các phương pháp từ T-MAC để tăng tốc các hoạt động bit thấp.
- Thực thi không mất mát (Lossless Inference): Mặc dù lượng tử hóa cực hạn, các mô hình 1.58-bit vẫn duy trì hiệu suất cực kỳ gần với các phiên bản độ phân giải đầy đủ (full-precision).
Phần 3: Chẩn đoán (The Diagnosis)
Điều này thực sự có ý nghĩa gì đối với các nhà phát triển? Tác động là rất lớn, đặc biệt là đối với việc chạy AI cục bộ trên phần cứng của người dùng cá nhân.
Những con số (Hiệu suất trên CPU)
- CPU x86: Tốc độ tăng từ 2,37 lần đến 6,17 lần.
- CPU ARM: Tốc độ tăng từ 1,37 lần đến 5,07 lần.
- Tiết kiệm năng lượng: Giảm tiêu thụ năng lượng cực khủng từ 70% đến 80%.
- Cột mốc “Tốc độ Đọc của Con người”: Bạn có thể chạy một mô hình 100 tỷ tham số trên một CPU duy nhất với tốc độ tương đương tốc độ đọc của con người (5-7 token/giây).
Deep Dive: Các tính năng tối ưu hóa
Các bản cập nhật gần đây đã giới thiệu “Cấu trúc song song kích hoạt” (Activation Parallelism), giúp dàn trải chi phí giải nén trọng số (weight unpacking) trên nhiều phần tử, giúp tăng thông lượng hơn nữa cho việc xử lý câu lệnh (GEMM) và tạo token (GEMV).
# Quá trình thiết lập được tự động hóa cao thông qua các script Python
# Lượng tử hóa embedding sang Q6_K giúp cân bằng giữa bộ nhớ và tốc độ
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s --quant-embd
Phần 4: Giải pháp (The Resolution)
Bạn đã sẵn sàng chạy một mô hình LLM khổng lồ trên CPU máy tính xách tay của mình chưa? Đây là lộ trình:
- Clone Repo:
git clone --recursive https://github.com/microsoft/BitNet. - Biên dịch: Cài đặt các phụ thuộc (
python,cmake,clang) và chạy script thiết lập. - Tải Mô hình: Sử dụng
huggingface-cliđể tải phiên bản GGUF củaBitNet-b1.58-2B-4T. - Thực thi: Chạy
run_inference.pyđể bắt đầu trò chuyện.
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "Explain quantum computing in simple terms" -cnvMô hình tâm trí cuối cùng
BitNet = Trọng số Tam phân + Kernel Chỉ-Cộng + Khả năng mở rộng cục bộ.
Nó đại diện cho một sự thay đổi tư duy, nơi băng thông bộ nhớ và năng lượng không còn là những rào cản tuyệt đối cho AI quy mô lớn. Bằng cách đơn giản hóa các phép toán cơ bản của LLM, BitNet biến giấc mơ “chạy mô hình 100B trên CPU” thành hiện thực ngay hôm nay.
Bài viết liên quan
- AI & Agents
16 con số để chạy mô hình ngàn tỉ tham số
FP4, định dạng số thực 4-bit với đúng 16 giá trị, đang là chuẩn mặc định để chạy các mô hình ngôn ngữ lớn trên GPU Blackwell của NVIDIA.
6 phút đọcĐọc tiếp → - AI & Agents
Kiến trúc đơn giản đến khó tin đứng sau cơn sốt AI
Một bài bóc tách từ gốc cách các LLM transformer thật sự hoạt động: token, embedding, attention và vòng lặp đoán từ kế tiếp - không phương trình.
7 phút đọcĐọc tiếp → - AI & Agents
9Router Là Gì: Hướng Dẫn Dùng AI Coding Miễn Phí & Tự Động Fallback
9Router là gì? Khám phá local proxy ngồi giữa Claude Code, Cursor và 40+ provider, tự fallback khi hết quota, nén token 20-40% giúp code AI thả ga.
11 phút đọcĐọc tiếp → - AI & Agents
CTF Bây Giờ Là Đấu Token, Không Phải Đấu Não
Một tay chơi CTF hàng đầu thế giới tuyên bố: Claude Opus 4.5 và GPT-5.5 đã tự động hoá đủ bảng xếp hạng để CTF mở không còn đo skill bảo mật nữa.
7 phút đọcĐọc tiếp →