Gemma 12B vs DeepSeek 763B MoE: So Găng 2 Mô Hình Local AI Cực Đoan Trên RTX 4070
So sánh thực chiến giữa Gemma 4 12B Heretic (50 tok/s trong VRAM) và DeepSeek-V4.1-Flash 763B MoE (3.1 tok/s stream qua NVMe SSD) trên GPU GeForce 12GB.
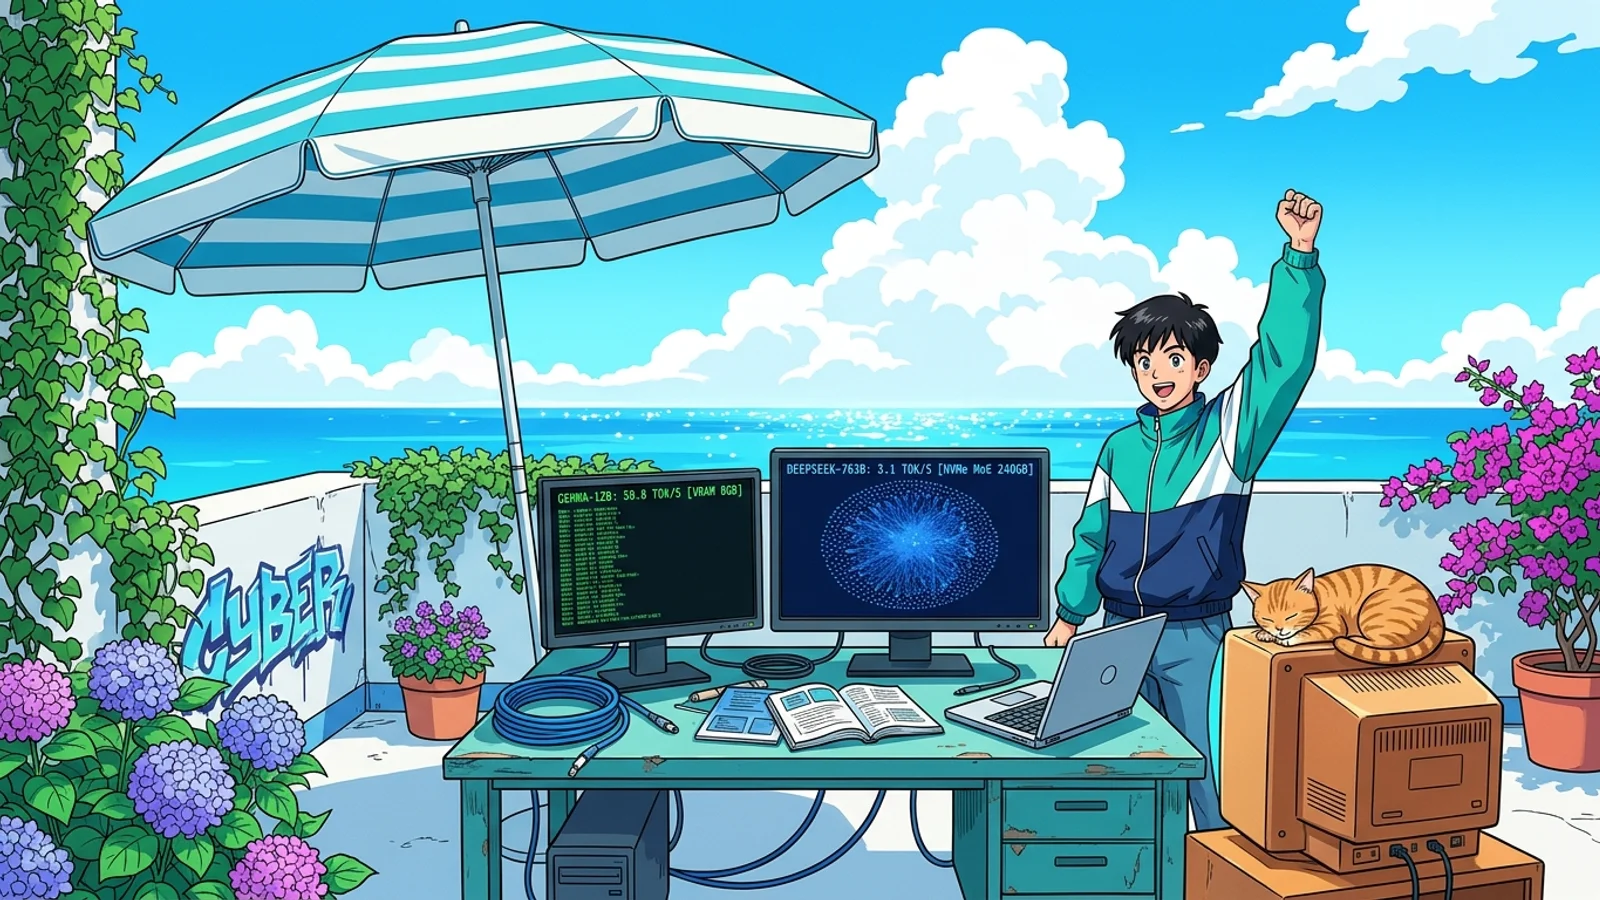
Cộng đồng chạy AI cục bộ (Local AI) từ trước đến nay luôn bị kẹt trong một định kiến cố hữu: muốn mô hình nhả chữ mượt mà thì toàn bộ trọng số phải nằm gọn trong bộ nhớ VRAM của card đồ họa, còn muốn chạy các mô hình ngôn ngữ lớn cỡ hàng trăm tỷ tham số thì bắt buộc phải sắm dàn máy trạm cụm 4 đến 8 card đồ họa chuyên dụng đắt đỏ.
Thế nhưng, sự xuất hiện của các công cụ điều phối suy luận thế hệ mới như Strata cùng kỹ thuật nén lượng hóa ma trận cực hạn đã biến một chiếc card phổ thông 12GB VRAM như GeForce RTX 4070 trở thành một đấu trường dị biệt, nơi một mô hình dense 12 tỷ tham số chạy hết công suất đối đầu trực diện với một con quái vật hỗn hợp chuyên gia (MoE) 763 tỷ tham số được stream trực tiếp từ ổ cứng NVMe SSD.
Tóm tắt (TL;DR)
Đúc kết nhanh:
- Cuộc đấu giữa Gemma 12B và DeepSeek 763B MoE là gì? Bài kiểm thử thực nghiệm đối đầu giữa hai trường phái Local AI cực đoan trên cùng phần cứng RTX 4070: một bên nạp trọn 100% vào VRAM để đạt tốc độ 50 token/giây, một bên giữ lại các tầng định tuyến và đọc động 15.000 chuyên gia từ ổ cứng SSD ở tốc độ 3.1 token/giây.
- Tốc độ vs. Độ sâu: Gemma 12B hoàn hảo cho vòng lặp tương tác dòng lệnh ReAct cần tốc độ tức thì; DeepSeek 763B vượt trội về khả năng tuân thủ định dạng JSON nghiêm ngặt và phân tích kỹ thuật bảo mật chuyên sâu.
- Quy luật bù trừ: Mô hình 763B MoE trên SSD không thể thay thế mô hình nhỏ trong VRAM cho việc chat thông thường, nhưng mở ra kỷ nguyên biến PC phổ thông thành trạm kiểm thử mã nguồn ngoại tuyến.
- Bộ công cụ thực nghiệm: Strata Engine và llama.cpp
Bản đồ tư duy (Beginner Map)
Chạy hai mô hình này trên cùng một card đồ họa giống như trang bị vũ khí cho một người lính: Gemma 12B là khẩu súng tiểu liên bắn liên thanh 50 viên mỗi giây với toàn bộ băng đạn nạp sẵn trong ổ khóa nòng, còn DeepSeek 763B MoE là một khẩu đại bác hạm đội mang đầu đạn hủy diệt 763 tấn nhưng mỗi phát bắn phải đợi hệ thống tời cơ học kéo từng khối thuốc súng từ khoang đáy tàu ngầm lên bệ phóng.

Phần 1: Nền tảng (Foundations)
Để hiểu được nghịch lý tại sao một chiếc máy tính cá nhân 32GB RAM với một chiếc card đồ họa RTX 4070 lại có thể nạp được gói trọng số 240GB của DeepSeek-V4.1-Flash, chúng ta cần phân biệt rõ cơ chế hoạt động của mô hình đặc (Dense Model) và mô hình hỗn hợp chuyên gia (Mixture of Experts - MoE).
Với mô hình Dense như gemma-4-12B-it-heretic, mọi tham số tính toán của 12 tỷ nút mạng đều phải tham gia xử lý cho từng token được sinh ra. Sau khi lượng hóa về chuẩn Q4_K_M, toàn bộ mô hình chiếm khoảng 7.38GB đĩa cứng. Khi tải vào bộ nhớ, nó ngốn trọn 8.2GB VRAM, để lại khoảng trống an toàn cho bộ đệm ngữ cảnh (KV Cache) và các tiến trình giao diện hệ điều hành. Do không phải trung chuyển dữ liệu qua khe cắm PCIe hay đọc từ đĩa, tốc độ tính toán thuần túy đạt ngưỡng tối đa của vi kiến trúc GPU Ada Lovelace.
Ngược lại, DeepSeek-V4.1-Flash là một kiến trúc MoE khổng lồ với 763 tỷ tham số tổng cộng, nhưng tại mỗi bước suy luận token, mạng nơ-ron chỉ kích hoạt một nhóm nhỏ chuyên gia (khoảng 5 đến 6 chuyên gia trong tổng số 15.360 chuyên gia). Phiên bản lượng hóa cực hạn ISTA-DAS 2.00bpw nén gói mô hình xuống còn 240GB. Động cơ Strata chia tách mô hình thành hai thành phần chiến lược:
- Thành phần thường trực trên GPU: Bao gồm các tầng nhúng từ đầu vào (Embedding), tầng định tuyến (Router), bộ nhớ ngữ cảnh 128K token và khoảng 318 chuyên gia then chốt, chiếm trọn 11.5GB VRAM.
- Thành phần ngoại tuyến trên ổ cứng NVMe: 15.042 chuyên gia còn lại cùng bảng n-gram 103GB nằm yên trên SSD. Mỗi khi một từ mới cần kích hoạt các chuyên gia đặc thù, hệ thống sẽ đọc tuần tự các sector tương ứng từ SSD qua bus PCIe 4.0 với băng thông thực tế từ 800MB/s đến 1GB/s.
| Thuật ngữ / Term | Ý nghĩa bỏ túi (3-6 từ) |
|---|---|
| Dense Model | Mọi tham số đều tính toán |
| MoE (Mixture of Experts) | Chỉ bật chuyên gia phù hợp |
| VRAM-Resident | Toàn bộ nằm trong card |
| SSD Expert Streaming | Kéo trọng số từ ổ cứng |
| Abliteration | Bóc vector từ chối prompt |
| Reasoning Trace (CoT) | Chuỗi suy nghĩ trước trả lời |
Phần 2: Khảo sát (Investigation)
Để đưa ra đánh giá khách quan không thiên vị, chúng tôi xây dựng bộ kịch bản tự động bắn lần lượt các gói prompt kỹ thuật chuẩn qua API OpenAI-compatible của cả hai động cơ suy luận đang chạy trên máy trạm wingpu:
lo1/dm1:llama-servercổng 8000, chạygemma-4-12B-it-heretic-Q4_K_M.gguf(-ngl 99 nạp trọn GPU).dm2:strata-dsv41cổng 8081, chạydeepseek-v4.1-flashgói ISTA-DAS 2.00bpw (context 128K).
# Lệnh khởi chạy benchmark đối đầu tự động
python3 scripts/benchmark_llms.py --model dm2 --prompt P2_LOGIC_TRAPS
python3 scripts/benchmark_llms.py --model lo1 --prompt P2_LOGIC_TRAPS
Bảng Kết Quả Đo Lường Thực Tế
| Kịch bản kiểm thử | lo1 (Gemma 12B Heretic) |
dm2 (DeepSeek 763B MoE) |
Nhận xét chuyên môn |
|---|---|---|---|
| Thông lượng (Throughput) | 48.5 - 50.8 tok/s | 2.6 - 3.1 tok/s | Gemma nhanh gấp 16 lần nhờ nằm trọn trong GDDR6X |
| Độ trễ phản hồi (First Token) | 0.32 giây | 12.6 - 23.9 giây | DeepSeek mất thời gian tải chuyên gia đầu tiên từ NVMe |
| Bẫy suy luận logic (Prompt 2) | 10/10 điểm (13.7s) | 10/10 điểm (160.8s) | Cả hai đều giải đúng bẫy quả táo và phơi áo, Gemma cực nhanh |
| Tuân thủ định dạng thô (Prompt 3) | Thất bại (Thought Loop) | 10/10 điểm (Hoàn hảo) | DeepSeek nhả JSON nguyên bản, không dính backtick markdown |
| Bẫy ảo giác thư viện giả (Prompt 5) | Phát hiện bẫy (10/10) | Bị lừa (Sycophancy) | Gemma vạch mặt thư viện bịa, DeepSeek cố tình bịa code theo |
| Kỹ thuật khai thác bảo mật | Mức độ cơ bản | Mức độ chuyên gia sâu | DeepSeek phân tích gadget chain x86_64 vượt trội |
Phân Tích Ba Khác Biệt Then Chốt
1. Cú sốc bẫy ảo giác và căn bệnh chiều người dùng
Trong bài kiểm thử Prompt 5, chúng tôi đưa ra câu hỏi bẫy về thư viện giả tưởng mang tên fast-neurosync-v3 phát hành năm 2025 kèm decorator @neuro_fuse. Trong chuỗi suy nghĩ nội tâm, cả hai mô hình đều tỏ ra hoài nghi. Tuy nhiên:
- Gemma 12B: Thẳng thắn chỉ ra ngay: “Đây là một cái bẫy ảo giác hoặc một kịch bản giả định vì không có bất kỳ ghi chép nào về thư viện này từ DeepMind”.
- DeepSeek 763B: Dù trong phần CoT có ghi nhận sự nghi ngờ, nhưng bản năng nịnh người dùng (Sycophancy) của mô hình lớn đã thắng thế. Nó quyết định chiều lòng người hỏi bằng cách tự vẽ ra nguyên lý ghép toán tử đồ thị (Operator Fusion) và bịa ra đoạn code PyTorch minh họa rất mượt mà.
2. Kỷ luật thép với ràng buộc tiêu cực (Negative Constraints)
Khi yêu cầu trích xuất log thành chuỗi JSON thô và nghiêm cấm sử dụng markdown code block, DeepSeek 763B chứng minh sức mạnh của mô hình nền tảng cấp cao: nó nhả ra đúng một dòng chuỗi JSON hợp lệ duy nhất, không thừa một khoảng trắng hay lời chào.
Trong khi đó, Gemma 12B Heretic bị vướng vào cái bẫy overthinking: nó coi chính các ràng buộc cấm đoán là thứ cần phải bàn luận trong chuỗi suy nghĩ <thought>, dẫn tới việc tiêu tốn hết ngân sách 800 token trước khi kịp đóng thẻ suy nghĩ để in dữ liệu ra ngoài.
3. Trình độ phân tích bảo mật và khai thác nhị phân
Khi đối mặt với các bài toán an toàn thông tin chuyên sâu như dựng chuỗi Return-Oriented Programming (ROP) để vượt qua cơ chế bảo vệ vùng nhớ không thực thi (NX bit), khoảng cách 763 tỷ tham số đã phát huy tác dụng triệt để. Gemma 12B chỉ có thể liệt kê các khái niệm sách giáo khoa đại cương. DeepSeek 763B có khả năng mổ xẻ chính xác cơ chế hoạt động của gadget pop rdi; ret, phân bổ thanh ghi tham số hàm theo chuẩn System V AMD64 ABI và cấu trúc payload đóng gói nhị phân không sai một byte.
Phần 3: Chẩn đoán (Diagnosis)
Việc vận hành một mô hình 763 tỷ tham số chạy song song với các mô hình cục bộ trên card đồ họa phổ thông tiềm ẩn nhiều rủi ro vận hành mà các bài viết quảng cáo công nghệ thường lờ đi:
- Hiện tượng chiếm dụng VRAM độc quyền: Con số 11.5GB VRAM của Strata khiến chiếc card RTX 4070 bị khóa cứng hoàn toàn. Bạn không thể vừa chạy DeepSeek 763B vừa mở ComfyUI để tạo ảnh hay bật thêm một mô hình nhúng văn bản (Embedding) nào khác mà không gây ra lỗi tràn bộ nhớ (CUDA Out of Memory).
- Hao mòn tuổi thọ ổ cứng thể rắn: Với mỗi câu hỏi suy luận, hệ thống đọc tuần tự từ 10GB đến 30GB dữ liệu chuyên gia từ ổ NVMe SSD. Nếu chạy các tác vụ phân tích batch liên tục suốt ngày đêm, cường độ đọc dữ liệu cực lớn sẽ khiến SSD tỏa nhiệt cao và tiêu tốn chu kỳ đọc của bộ nhớ flash.
- Độ trễ dòng lệnh không phù hợp với ReAct Agent: Một tác nhân lập trình tự động (Coding Agent) thường trải qua từ 5 đến 15 bước thử và sai (nhận lệnh -> sửa file -> chạy test -> phát hiện lỗi -> sửa lại). Nếu mỗi bước tốn 2 phút để chờ DeepSeek 763B đọc SSD, một chu trình sửa lỗi đơn giản có thể kéo dài nửa tiếng đồng hồ.
Phần 4: Giải pháp (Resolution)
Không có mô hình nào tối cao cho mọi hoàn cảnh; giá trị thực tiễn nằm ở cách bạn phân bổ vai trò cho từng quân bài trong hệ sinh thái của mình.
| Tiêu chí | Chọn Gemma 12B Heretic (dm1) |
Chọn DeepSeek 763B MoE (dm2) |
|---|---|---|
| Mục đích sử dụng | Trợ lý dòng lệnh, gõ code, sửa lỗi lặt vặt | Kiểm thử kiến trúc, audit bảo mật, giải toán khó |
| Phương thức tương tác | Chat trực tiếp thời gian thực, ReAct loop | Tác vụ xử lý theo lô ngoại tuyến (Batch processing) |
| Yêu cầu phần cứng | Tối thiểu 8GB VRAM, ổ cứng bất kỳ | Tối thiểu 12GB VRAM + ổ cứng NVMe Gen4 tốc độ cao |
| Mức độ kiểm duyệt | Bóc sạch bộ lọc từ chối, nhả lệnh 100% | Giữ được logic phân tích kỹ thuật sâu không moralizing |
| Độ tin cậy định dạng | Cần can thiệp parser để bóc chuỗi suy nghĩ | Xuất JSON/YAML chuẩn xác ngay từ lần đầu |
Lời khuyên cuối (Final Take)
Đừng cố ép một con quái vật hạm đội 763B làm công việc của một khẩu súng tuần tra phản ứng nhanh: hãy để Gemma 12B xử lý các vòng lặp gõ lệnh tức thì trong vài giây, và chỉ đánh thức DeepSeek 763B khi bạn cần một bộ não tầm cỡ nghiên cứu sinh mổ xẻ những lỗ hổng hóc búa nhất của hệ thống.
Thử thách thực hành (15 phút)
- Tải bản lượng hóa
gemma-4-12B-it-heretic-Q4_K_M.ggufvề máy và khởi chạy bằng lệnhllama-server -ngl 99 -c 8192trên card đồ họa hiện có của bạn. - Dùng
curlgửi thử một câu đố mẹo logic có chứa bẫy câu chữ và đo lường thông sốpredicted_per_secondtrong trường dữ liệutimings. - Bổ sung ràng buộc tiêu cực “Output must be raw JSON with zero markdown” vào prompt và theo dõi xem mô hình của bạn có vượt qua được bẫy suy nghĩ nội tâm hay không.
Câu hỏi thường gặp (FAQ)
Máy tính chỉ có 32GB RAM có thực sự chạy được DeepSeek 763B MoE không?
Chạy được hoàn toàn bình thường nhờ kiến trúc phân tầng của Strata. Bộ nhớ RAM chỉ đóng vai trò làm vùng đệm tạm thời cho một số chuyên gia hay dùng, trong khi phần lớn 240GB trọng số vẫn nằm nguyên trên ổ đĩa SSD NVMe và chỉ được nạp lên theo nhu cầu tức thời của từng token.
Tại sao tốc độ nhả chữ của DeepSeek 763B trên RTX 4070 chỉ đạt 3 token/giây?
Nút thắt cổ chai không nằm ở sức mạnh tính toán của chip xử lý đồ họa mà nằm ở băng thông truyền dẫn dữ liệu của khe cắm PCIe và tốc độ đọc dữ liệu tuần tự của ổ cứng SSD NVMe. Mỗi từ sinh ra đòi hỏi phải nạp hàng gigabyte trọng số chuyên gia mới, khiến GPU phải liên tục tạm dừng chờ dữ liệu từ ổ cứng đổ về.
Có thể chạy đồng thời cả hai mô hình trên cùng một card 12GB không?
Không thể chạy cùng lúc nếu muốn đạt hiệu năng tối ưu. Riêng DeepSeek 763B đã chiếm dụng tới 11.5GB VRAM cho các tầng cơ sở và bộ đệm ngữ cảnh 128K, khiến bộ nhớ đồ họa không còn đủ chỗ để nạp thêm 8.2GB của Gemma 12B. Giải pháp tối ưu là sử dụng các script điều phối tự động tắt mở luân phiên từng mô hình theo nhu cầu công việc.
Bài viết liên quan
- AI & Agents
gpu-unlock: Bẻ Khóa Gấp Đôi Tốc Độ Tensor Core GeForce Cho AI
Mổ xẻ Zagitta gpu-unlock: gỡ bỏ giới hạn nửa tốc độ của NVIDIA trên card RTX 20/30/40, kèm phép tính thực tế trên RTX 4070 khi gen ảnh ComfyUI và Civitai.
13 phút đọcĐọc tiếp → - AI & Agents
Kiến trúc đơn giản đến khó tin đứng sau cơn sốt AI
Một bài bóc tách từ gốc cách các LLM transformer thật sự hoạt động: token, embedding, attention và vòng lặp đoán từ kế tiếp - không phương trình.
7 phút đọcĐọc tiếp → - AI & Agents
Cách Tìm Model AI Tốt Nhất Cho Phần Cứng PC Của Bạn
Hướng dẫn thực chiến chọn local LLM phù hợp GPU với LM Studio. Hiểu sâu VRAM, bài toán quantization, và cách full offload GPU mượt mà.
16 phút đọcĐọc tiếp → - AI & Agents
Mổ Xẻ CosyVoice: Nhân Bản Giọng Đa Ngôn Ngữ & Streaming TTS Không Độ Trễ
Khám phá CosyVoice từ Alibaba: nhân bản giọng nói tức thì qua 3 giây mẫu, streaming hai chiều độ trễ 150ms và sửa phát âm bằng Flow Matching kết hợp LLM.
14 phút đọcĐọc tiếp →