1 Byte = 8 Bit: Tên Bạn Tốn Bao Nhiêu Byte Trong Bộ Nhớ?
1 byte = 8 bit. Giải thích trực quan về bit, byte, mã ASCII và UTF-8 thông qua mô hình bãi đỗ xe cùng công thức tính chính xác dung lượng tên của bạn trong bộ nhớ.
TL;DR
Đúc kết nhanh:
- 1 byte bằng bao nhiêu bit? Chính xác 1 byte = 8 bit (
1 Byte = 8 Bits). Mỗi bit là một chữ số nhị phân (0 hoặc 1), cho phép 1 byte biểu diễn được2^8 = 256giá trị khác nhau (từ 0 đến 255).- Tên của bạn tốn bao nhiêu byte? Trong bảng mã ASCII / UTF-8 tiêu chuẩn, mỗi chữ cái tiếng Anh không dấu tốn đúng 1 byte (8 bit). Ví dụ, tên “Hoang” (5 chữ cái) tốn đúng 5 byte (40 bit), trong khi tên “Hoàng 🦈” tốn 11 byte (88 bit) do dấu tiếng Việt (“à”) tốn 2 byte và emoji cá mập tốn 4 byte.
- Công thức quy đổi:
Số Byte = Số Bit / 8.
Tôi từng nói chuyện với một đồng nghiệp có thể đọc vanh vách “1 byte = 8 bit” ngay cả khi đang mơ ngủ, nhưng lại đứng hình khi bị hỏi: “Tên của mày tốn bao nhiêu byte?”
Giờ thì ta xử lý câu hỏi đó.
Mô hình Bãi Đỗ Xe
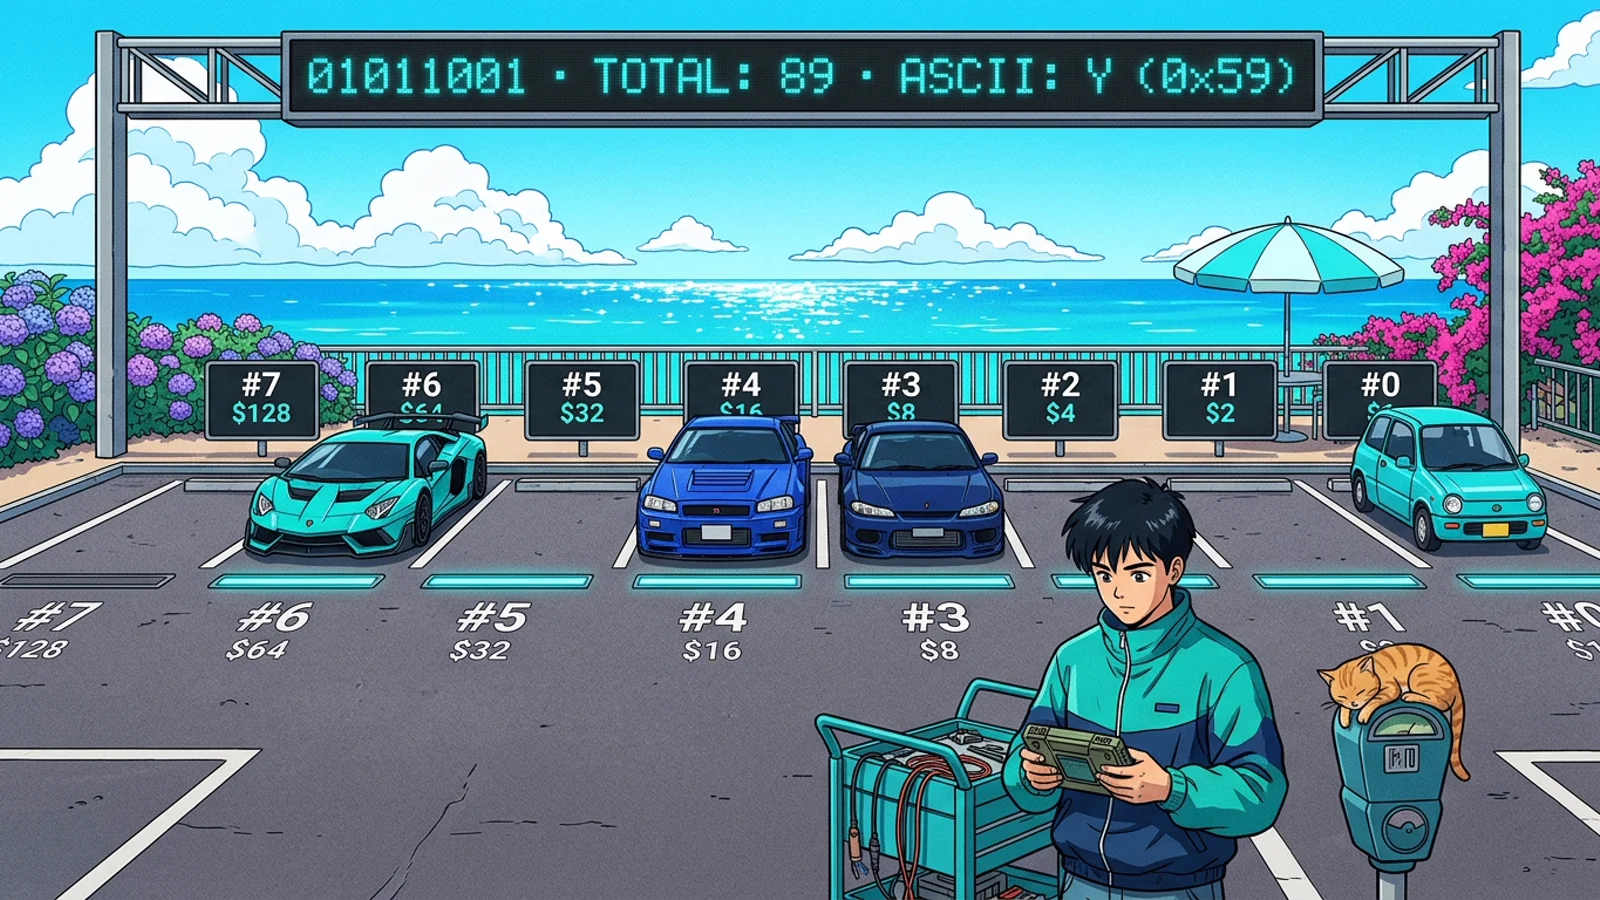
Hãy tưởng tượng một bãi đỗ xe có 8 ô. Mỗi ô hoặc trống (0) hoặc có xe (1). Cả bãi đó chính là một byte.
| Ô # | 7 | 6 | 5 | 4 | 3 | 2 | 1 | 0 |
|---|---|---|---|---|---|---|---|---|
| Giá | $128 | $64 | $32 | $16 | $8 | $4 | $2 | $1 |
- 1 byte = 1 bãi đỗ với 8 ô
- 1 bit = 1 ô (trống = 0, có xe = 1)
- Mỗi ô có một mức giá theo vị trí: ô 0 giá $1, ô 1 giá $2, ô 7 giá $128
- Tổng doanh thu = tổng mức giá của các ô đang có xe
Đây là trực quan hóa cấu trúc của một byte:
00000001 → chỉ ô cuối có xe → doanh thu = 1
00000010 → ô kế bên có xe → doanh thu = 2
11111111 → cả 8 ô đều đầy → doanh thu = 128 + 64 + 32 + 16 + 8 + 4 + 2 + 1 = 255
Con số (0-255) chỉ phụ thuộc vào việc ô nào có xe.
ASCII
Vì sao máy tính lại nhóm 8 bit (2³) thành 1 byte? Sao không phải 6 hay 10?
Câu trả lời ngắn: 8 bit là kích thước “vừa đẹp” cho văn bản. 🐧
ASCII Character Set
Để lưu văn bản, máy tính cần ánh xạ ký tự → số. Với 8 bit, bạn có 256 giá trị (0-255). Chừng đó đủ chứa mọi chữ cái tiếng Anh (a-z, A-Z), chữ số và ký hiệu, còn dư chỗ.
Hãy nghĩ 256 giá trị này như 256 cấu hình bãi đỗ xe khác nhau. Mỗi cấu hình tương ứng với một ký tự.
ASCII chuẩn thực tế chỉ dùng 7 bit (128 giá trị, 0-127). Byte thứ 8 ban đầu được dùng làm bit kiểm tra chẵn lẻ (parity check) hoặc mở rộng bảng mã (extended ASCII).
Đây là trực quan hóa cách ký tự được phân bố trong byte:
ASCII Encoding
Vậy làm sao chuyển qua lại giữa ký tự và byte như hình minh họa ở trên?
Lấy ví dụ mã hóa chữ “Y” (trong YELL).
Bước 1: Character set Ký tự → Số
Tra bảng ASCII: Y = 89
Bước 2: Encoding Số → Nhị phân
Đây là chỗ nhiều người kẹt. Hãy dùng phương pháp thử-bit (bit-test). Thuộc lòng dãy: 128, 64, 32, 16, 8, 4, 2, 1
Bắt đầu với 89 và đi từ trái sang phải:
- 89 ≥ 128? ❌ → 0
- 89 ≥ 64? ✅ → 1 (89 − 64 = 25)
- 25 ≥ 32? ❌ → 0
- 25 ≥ 16? ✅ → 1 (25 − 16 = 9)
- 9 ≥ 8? ✅ → 1 (9 − 8 = 1)
- 1 ≥ 4? ❌ → 0
- 1 ≥ 2? ❌ → 0
- 1 ≥ 1? ✅ → 1
128 | 64 | 32 | 16 | 8 | 4 | 2 | 1
  0 |  1 |  0 |  1 | 1 | 0 | 0 | 1
Kết quả: 01011001. Đó là một byte.
Cách chia 2 liên tục lấy phần dư cũng cho kết quả tương đương.
Chuyển đổi tư duy:
- Con người nghĩ theo ký tự
- Máy tính nghĩ theo byte
- Encoding là lớp phiên dịch giữa hai thế giới

Lớn Hơn ASCII
ASCII ổn với tiếng Anh. Nhưng còn 🦈, 你, ộ, hay ắ?
256 giá trị là không đủ. Ta cần một thứ “to hơn”.
Bộ ký tự Unicode
Hỏi: Unicode có giống ASCII nhưng “bự hơn” không?
Đáp: Cũng gần đúng, nhưng chưa đủ chính xác.
ASCII có 2 phần:
- Bộ ký tự (character set): đổi ký tự → số thập phân
- Encoding: đổi số thập phân → nhị phân
Unicode là tiêu chuẩn định nghĩa không gian mã số (code point) cho mọi ký tự trên thế giới, còn cách ghi từng code point thành chuỗi byte cụ thể trên đĩa hoặc đường truyền là nhiệm vụ của các chuẩn mã hóa như UTF-8, UTF-16 hay UTF-32.
| Ký tự | Code Point | Thập phân |
|---|---|---|
| 🦈 | U+1F988 | 129,416 |
| 你 | U+4F60 | 20,320 |
| ộ | U+1ED9 | 7,897 |
| ắ | U+1EAF | 7,855 |
Unicode 18.0 (9/2026) định nghĩa 172.808 ký tự, nằm trong không gian 1.114.112 code point.
Phần “encoding” (lưu bằng byte ra sao)? Đó là lúc UTF-8 xuất hiện.
UTF-8 Encoding
Code point → byte. Làm thế nào?
Với ASCII, một ký tự tương ứng một byte. Nhưng 🦈 là 129,416 (vượt xa 255), một byte đơn lẻ không thể chứa nổi. Ta cần cơ chế xâu chuỗi nhiều byte lại với nhau.
UTF-8: Hệ thống xâu chuỗi nhiều bãi
Xâu chuỗi nhiều bãi tạo ra một vấn đề: máy tính biết đâu là điểm kết thúc của một ký tự và bắt đầu của ký tự kế tiếp?
UTF-8 giải quyết bằng khuôn byte (byte templates). Vài bit đầu cho biết bạn cần đọc bao nhiêu byte.
| Số byte | Khuôn |
|---|---|
| 1 | 0xxxxxxx |
| 2 | 110xxxxx 10xxxxxx |
| 3 | 1110xxxx 10xxxxxx 10xxxxxx |
| 4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
Các tiền tố (110, 1110, 11110) nói với máy tính: “Tôi là ký tự nhiều byte, hãy đọc thêm X byte nữa.”
Ví dụ: mã hóa 🦈
- Tìm code point: 🦈 = U+1F988 = 129,416
- Kiểm tra khoảng: 129,416 nằm trong 65,536 - 1,114,111 → cần 4 byte
- Đổi sang nhị phân: biểu diễn code point ở dạng nhị phân (21 bit)
- Nhét vào khuôn: phân phối các bit đó vào khuôn 4 byte
Áp dụng với Python
Trong Python, text (str) và raw bytes (bytes) là hai kiểu khác nhau.
strlà Unicode text (chuỗi các code point)encode("utf-8")biến text đó thành đúng các byte sẽ được lưu/truyền đi
>>> char = "🦈"

>>> char.encode("utf-8")
b'\xf0\x9f\xa6\x88'

>>> list(char.encode("utf-8"))
[240, 159, 166, 136]

>>> char.encode("utf-8").hex()
'f09fa688'
Bạn đang thấy gì ở đây:
- Tiền tố
b'...'biểu thị kiểu byte thô (không phải text). - Mỗi
\x..là một byte hệ thập lục phân (f0,9f,a6,88), tương ứng thập phân[240, 159, 166, 136]. - Do code point của 🦈 vượt qua ngưỡng 65.535, UTF-8 kích hoạt khuôn 4 byte.
Và bạn luôn có thể decode ngược lại thành text:
>>> b'\xf0\x9f\xa6\x88'.decode('utf-8')
'🦈'
Cạm Bẫy Thực Chiến: UTF-8 BOM, Cắt Chuỗi & Đếm Ký Tự (Gotchas)
Dưới đây là 3 cạm bẫy thực tế mà hầu hết lập trình viên từng dính chấu ít nhất một lần trong dự án:
-
Cạm bẫy UTF-8 BOM (
\xef\xbb\xbf) làm gãy Parser: BOM (Byte Order Mark) là 3 byteEF BB BFmà Excel (khi xuất CSV) tự chèn vào đầu file UTF-8. UTF-8 hoàn toàn không cần BOM. Hậu quả là các parser JSON nghiêm ngặt (JSON.parse,jq, hay Pythonjson.load) sẽ ném lỗiUnexpected tokenvì byte đầu tiên không phải{mà làU+FEFF.# Soi 3 byte đầu file để bắt quả tang BOM xxd -g 1 -l 3 file.json# Đọc file an toàn tự động nuốt BOM trong Python open("file.json", "r", encoding="utf-8-sig").read() -
Cạm bẫy cắt chuỗi theo Byte làm vỡ ký tự (Mojibake): Nếu bạn dùng hàm cắt byte kiểu
buffer[:10]trúng vào giữa ký tự 4-byte như emoji🦈(ví dụ cắt ngay tại byte thứ 2), bạn sẽ tạo ra một chuỗi byte mồ côi không hợp lệ. Trình duyệt hoặc terminal sẽ biến nó thành ký tự lỗi hình kim cương đen có dấu chấm hỏi `` (U+FFFD). Khi xử lý chuỗi đa byte, luôn cắt theo Code Point hoặc dùng thư viện có nhận biết ranh giới ký tự (Grapheme Clusters). -
Cạm bẫy
.lengthtrong JavaScript & Giới hạn Byte: Trong JavaScript, chuỗi được biểu diễn bằng UTF-16 code units:"🦈".length; // Ra 2 (Surrogate pair)! "Hoàng".length; // Ra 5 (mỗi ký tự dựng sẵn NFC) "Hoàng 🦈".length; // Ra 8 (nhưng tốn tới 11 bytes UTF-8 trên đường truyền!)Hàm
.lengthkhông đo số byte và cũng không đếm số ký tự người dùng nhìn thấy. Nếu hệ thống của bạn áp dụng giới hạn kích thước theo byte (network payload, Redis string, index prefix byte limit) mà nhầm lẫn vớistr.length, dữ liệu sẽ bị tràn giới hạn vì"Hoàng 🦈"tốn tới 11 bytes UTF-8 thực tế.⚠️ Lưu ý NFC vs NFD: Con số 11 bytes ở trên tính theo chuẩn NFC (ký tự dựng sẵn:
à=U+00E0tốn 2 bytes). Nếu trên macOS hoặc phần mềm gõ chữ dùng NFD (tách chữa+ combining accent\u0300), chữàsẽ tốn 1 + 2 = 3 bytes, đẩy tổng dung lượng"Hoàng 🦈"lên 12 bytes!
Tham khảo nhanh
| Khoảng code point | Kích thước | Ví dụ | Code Point | Thập phân | UTF-8 bytes (thập phân) |
|---|---|---|---|---|---|
| 0 - 127 (ASCII) | 1 byte | Y | U+0059 | 89 | 89 |
| 128 - 2,047 | 2 byte | é | U+00E9 | 233 | 195, 169 |
| 2,048 - 65,535 | 3 byte | 你 | U+4F60 | 20,320 | 228, 189, 160 |
| 65,536 - 1,114,111 | 4 byte | 🦈 | U+1F988 | 129,416 | 240, 159, 166, 136 |
Kết luận: cái hay của UTF-8 không chỉ là hỗ trợ emoji. Nó vẫn tương thích ASCII và mở rộng được ra toàn bộ không gian Unicode.
💡 Tính dung lượng thực tế tên của bạn:
- Tên tiếng Anh không dấu:
"Hoang"→ 5 ký tự ASCII = 5 bytes (40 bits).- Tên tiếng Việt có dấu kèm emoji:
"Hoàng 🦈"→H(1) +o(1) +à(2) +n(1) +g(1) +(1) +🦈(4) = 11 bytes (88 bits). Nếu viết liền không khoảng cách ("Hoàng🦈"), dung lượng là 10 bytes (80 bits). Ký tựà(U+00E0) thuộc dải 128-2.047 (2 bytes), còn🦈(U+1F988) thuộc dải 65.536-1.114.111 (4 bytes).
Máy tính lượng tử (Bonus)
Khác với bit cổ điển chỉ nhận 0 (trống) hoặc 1 (có xe), một qubit (quantum bit) tồn tại ở trạng thái chồng chập (superposition): chiếc xe vừa như có vừa như không. Chỉ khi thực hiện phép đo (measurement), hệ thống mới sụp đổ về trạng thái xác định 0 hoặc 1.
Nó giống “Ô đỗ xe của Schrödinger”. Rùng rợn? Có. Nhưng nhờ đó, máy tính lượng tử có thể tính toán rất nhiều khả năng song song.
Với tình trạng “lúc vui lúc buồn” đó, qubit dùng cho việc khác, không phải để lưu trữ như cách cổ điển.
Bảng Tổng Kết (Cheat Sheet)
| Khái niệm | Quy mô | Ví dụ nhị phân / Code Point | Giải thích |
|---|---|---|---|
| 1 Bit | 0 hoặc 1 | 0 (trống) hoặc 1 (có xe) |
Đơn vị nhị phân nhỏ nhất |
| 1 Byte | 8 Bits | 01011001 (89 = ‘Y’) |
2⁸ = 256 trạng thái (0..255), trọng số: 128, 64, 32, 16, 8, 4, 2, 1 |
| ASCII | 7 bit (chuẩn) / 8 bit (mở rộng) | ‘A’ = 65, ‘b’ = 98, ‘!’ = 33 | Đủ cho bảng chữ cái tiếng Anh và ký tự điều khiển |
| Unicode | Không gian 1.114.112 code points | U+1F988 (🦈), U+4F60 (你), U+1ED9 (ộ) |
Bộ ký tự toàn cầu gán mã số duy nhất cho mọi chữ viết |
| UTF-8 | Biến thiên 1 đến 4 bytes | 1B (ASCII) → 4B (Emoji) | Cơ chế mã hóa tương thích ngược với ASCII, định vị độ dài qua tiền tố bit |
| Qubit | Chồng chập lượng tử | α|0⟩ + β|1⟩ | Tồn tại đa trạng thái song song cho đến khi bị đo lường sụp đổ về 0 hoặc 1 |
Bài viết liên quan
- Software Craft
Coding Interview University: Tấm Bằng Khoa Học Máy Tính Tự Học
Giải mã Coding Interview University của John Washam: lộ trình tự học khoa học máy tính, cấu trúc dữ liệu và giải thuật chinh phục phỏng vấn Big Tech.
14 phút đọcĐọc tiếp → - Software Craft
Java Valhalla: Mười Hai Năm Để Xóa Một Giả Định
Sau một thập kỷ, Project Valhalla cuối cùng đã vào JDK 28 dạng preview. Cả dự án rút lại còn một ý: cho phép object từ bỏ identity để JVM xếp gọn như int.
7 phút đọcĐọc tiếp → - Software Craft
Bốn Thay Đổi Nhỏ Trong Python 3.15 Mà Ít Ai Để Ý
Python 3.15 có lazy imports và Tachyon profiler đình đám, nhưng bốn tính năng thực sự hữu ích lại là TaskGroup.cancel(), context manager decorator sửa đúng,…
7 phút đọcĐọc tiếp → - Software Craft
Khi Nào Nên Dùng Class vs. Function Trong Python: Checklist Thiết Kế
Mental checklist lặp lại được cho Python developer: khi nào dùng class, khi nào dùng function, instance state và dependency injection.
9 phút đọcĐọc tiếp →